VLM 评测
感知指标
Precision(Pk)
准确率
- TP:正确
- FP:错误
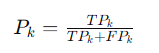
Recall(Rk)
被检测到的比例(召回率) ,即能看到多少,全不全
- TP:检测正确
- FN 漏检(False Negative)
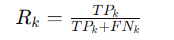
F1@k Score
精确率与召回率的调和平均,综合反映检测准确性;要求模型既要“看得准”(Precision 高)又要“看得全”(Recall 高)。
- @k 含义:容忍的误差范围。k = 0.5/1.0/2.0/4.0 m 为正样本距离阈值。k越小越严格
- eg:预测一辆车在 (10.0 m, 5.0 m),而真实在 (10.6 m, 5.3 m),对比预测距离和真实举例之间的距离是否在k之内
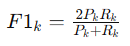
F1 (Lane Detection)
检测车道线的准确率。 看看模型画的线和真实车道线对不对齐。 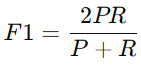
语言理解指标(Captioning)
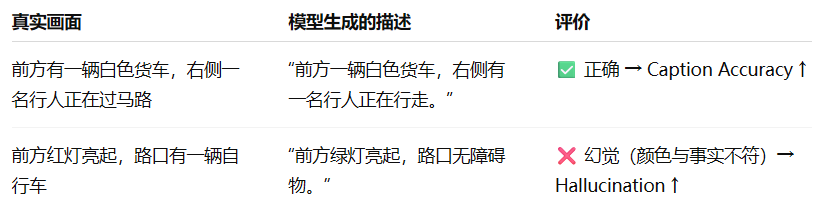
Caption Accuracy / Hallucination Rate
- Caption Accuracy(描述准确率)
- Hallucination Rate(幻觉率) eg:
规划指标(Planning)
衡量模型预测的行驶轨迹和真实轨迹差多远(→ L2 Error)以及模型会不会撞到别人(→ Collision Rate)。
L2 Error
衡量模型预测轨迹与真实驾驶者轨迹的平均欧氏距离。 L2 越小,说明车走得越接近真实路线,规划越准确
- 平均欧氏距离:
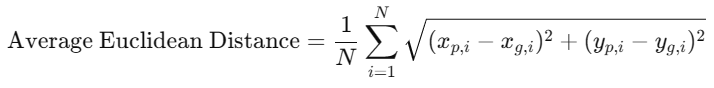
Collision Rate (%)(碰撞率)
Collision Rate 就是统计模型规划的路线中,有多少帧(时刻)与别的车或行人“相交”了。 假设在一次测试中共有 1000 帧行驶画面, 其中 3 帧出现了碰撞(与行人或其他车辆交叉):
模型消融指标
- 消融实验:把一个个指标去掉或者加回去重新跑实验看指标变化,比较不同结构效果差异
Avg. L2 / Avg. Col.(平均规划误差与碰撞率)
- Avg. L2:模型预测的行驶路线平均偏离真实轨迹的距离
- Avg. Col.(平均碰撞率):模型规划路线时平均发生碰撞的概率
《ORION: A Holistic End-to-End Autonomous Driving Framework by Vision-Language Instructed Action Generation》
ORION的核心贡献:让VLM的推理能力真正控制自动驾驶轨迹,让图像、推理、轨迹三者共享一个统一空间 三个核心部分打通“看场景-分析-出轨迹”的全流程
- QT-Former(记忆模块):专门记历史路况,比如说之前的车速,前方车辆位置。红绿灯变化等,不用每次都重新处理所有画面,而且能够捕捉长期规律(比如说红灯快变绿了提前准备走)
- 大语言模型(大脑模块):分析当前场景和历史信息,理解导航指令(比如左转),输出明确的驾驶规划(比如“减速避让行人”)
- 生成式规划期(执行器模块):把2的分析结果转换成具体的行车轨迹
闭环驾驶指标
闭环:模型真的开车,在线模拟实际驾驶能力
Driving Score (DS)
综合驾驶得分 Driving Score(DS)是 Bench2Drive / CARLA 官方用于评估自动驾驶系统总体表现的“综合得分” 综合路线完成度(Route Completion) + 违规扣分(Infraction Penalties)
Success Rate (SR)
成功完成路线比例
Efficiency
速度效率
Comfortness
舒适度
Multi-Ability(5 skill)
将自动驾驶拆分成5类能力:
- 并线:测试能否在主路交通流中顺利并入车道
- 超车:能否超过前方慢速车
- 紧急刹车
- 让行
- 交通标志响应 最终得分:成功任务数/总任务数
开环驾驶指标
开环:只预测,不执行,离线评估模型想怎么开。
Avg. L2 Error
预测轨迹与真实轨迹的平均欧氏距离误差
Collision Rate (%)
碰撞率:预测轨迹与物体相交的比例
语言理解指标
CIDEr
Consensus-based Image Description Evaluation
- 你写得“像不像一群人公认的好描述”。 文本生成质量指标,匹配共识或关键细节 用的是TF-IDF权重n-gram相似度,获得一个0~1或0~100的分数,分数越高越贴近人类真实描述
- 高频无意义词(the / is / a)权重低
- 稀有但关键的词(pedestrian, crosswalk, stop) 权重高
- 比对生成文本 vs 多条参考描述
BLEU
Bilingual Evaluation Understudy
- 你写得“像不像标准答案那句话”。 评估生成文本与参考文本之间在 n-gram(词组)层面的 精确匹配程度,匹配越多分数越高 即模型写的句子,有多少“词组(n-gram)”和人工参考句子一样
ROUGE-L
ROUGE:Recall-Oriented Understudy for Gisting Evaluation ROUGE-L:基于 最长公共子序列(LCS, Longest Common Subsequence) 的版本, 用于衡量模型的描述/回答是否覆盖了参考答案的关键信息
- 你写得“有没有把该说的内容都说到”。 设:
m= 参考答案长度(词数)n= 模型生成的句子长度LCS= 最长公共子序列的长度 可以构造:- 召回率(Recall):
R = LCS / m你覆盖了参考答案中多少比例的内容? - 精确率(Precision):
P = LCS / n你生成的内容中有多少是和参考匹配的? 然后通常会算一个类似 F1 的综合: ROUGE-L ≈F(LCS, m, n),结合 P 和 R
《ETA: Efficiency through Thinking Ahead,A Dual Approach to Self-Driving with Large Model》
解决问题:让超大模型在自动驾驶里也能做到实时响应 ETA通过一个Forecasting(未来预测模块),采用异步双系统架构,以空间复杂度换取时间复杂度
- 通过实时考量充分利用大型模型的优势
- 提出一个双重框架,分批预测大型模型推理和及时调整小型模型 大模型在t–Δ时刻预测当前帧,小模型在当前帧快速补充(大模型可能有些预测不到突然发生的事,比如行人突然冲出来、前车突然急刹等等)
闭环指标
Driving Score (DS)
综合驾驶得分 由Route Completion(路线完成度)和Infraction Penalties(违规扣分)等综合衡量
Success Rate (SR)
成功完成路线的比例
Efficiency
驾驶效率,衡量模型在驾驶过程中的“流畅性与高效性” 判断驾驶速度是否合理,是否在不必要时停下,是否顺畅完成驾驶动作
Comfort
舒适度,衡量自动驾驶模型在执行驾驶任务时的平稳性 包括加减速是否流畅、是否出现急刹/急加速、转向是否平稳、车辆是否存在来回晃动或犹豫停顿。Comfort 越高,表示乘客乘坐体验越好。
Latency (ms)
推理延迟 自动驾驶模型看到场景 → 理解 → 规划 → 输出方向盘/油门/刹车指令所需要的时间 即模型从接受传感器输入到输出控制指令所需要的时间
Mean Ability
五项能力得分均值 五项能力:Merging并线、Overtaking超车、Emergency Brake紧急刹车、Give Way让行、Traffic Sign交通标志响应
- 每一项公式都是
成功任务数/任务总数
《RoboTron-Drive:All-in-OneLargeMultimodalModelforAutonomousDriving》
Language
看回答像不像人话 评估回答的 语言形式质量,包括 是否是“正常句子”格式、是否正确、是否包含 AI 自述(如“作为一个AI模型…”)、是否存在乱码 空输出、是否语法混乱 不可读
- 计算标准:通常通过一套rule-based规则,按照规则累计分或者是扣分
Match
评估 回答内容与 Ground Truth 的语义重合度,不是 GPT 打分,而是 rule-based 对关键 token 对齐。 提取 GT 中的关键词(vehicle / pedestrian / turning right)进行匹配
《DOLPHINS: MULTIMODAL LANGUAGE MODEL FOR DRIVING》
Dolphins 是一个用于自动驾驶的多模态大模型(Vision-Language Model, VLM),能理解视频 + 文本输入,进行驾驶场景分析、预测、规划,并与人类进行对话式解释。
- 贡献
- 提出一个基于VLM的自动驾驶对话助手
- 提出 Grounded Chain-of-Thought(GCoT)推理增强(类似于CoT,但是加入了视觉grounding)
- 提出驾驶场景 in-context learning。
《CarLLaVA: Vision language models for camera-only closed-loop driving》
用 半解耦输出:Path + Waypoints
- Waypoints:预测未来 0.5s、1.0s、1.5s……车应该在哪
- Path:预测一条空间曲线
《DILU:AKnowledge-DrivenApproach to Autonomous Driving with Large Language Models》
给自动驾驶系统注入类似于人类驾驶员的知识驱动的能力 提出DiLu创新框架,通过整合人类知识没让LLM能够理解驾驶环境并且实现自动驾驶:
- 架构框架包含四个核心模块:
- 环境感知:实时监测外部环境
- 推理决策:述与过往经验生成决策提示
- 反思评估:对这些决策进行深度分析,识别出与经验相悖的不安全决策
- 记忆存储:修正后的经验数据存储到记忆模块
常用指标
BLEU
衡量 N-gram 的重合度
- 核心思想:
- N-gram精确率:看模型输出的字串(1-gram、2-gram、3-gram、4-gram)有多少能在参考答案里找到。
- 长度惩罚(Brevity Penalty, BP):防止模型输出特别短的句子骗分
ROUGE
评价文本生成质量的指标,看模型输出中是否包含参考答案中的重要内容,覆盖程度
- 包括:
- ROUGE-1:单词级别的召回,看模型输出覆盖标准答案的多少
- ROUGE-2:词对召回,查看模型输出是否保持部分词序
- ROUGE-L:最长公共子序列,衡量整体句子的结构相似性。 计算:ROUGE-L=最长公共子序列/标准答案长度
召回率:覆盖度
CIDEr
衡量语义内容一致性,强调关键词的重要性 CIDEr 尤其擅长奖励包含关键信息的句子(例如红灯、行人、刹车、变道)。
- 组成:
- TF-IDF词向量表示 TF:词频,某次在句子中出现次数越多,重要i星月高 IDF:逆文档频率:某词越罕见 → 权重越高
- n-gram匹配
- 余弦相似度 CIDEr reward = 若你提到关键内容 → 加很多分 CIDEr penalty = 若你漏掉关键内容 → 扣很多分
METEOR
Metric for Evaluation of Translation with Explicit ORdering 是一种用于评估 文本生成质量 的指标,比BLEU更智能,因为允许同义词、词干匹配、重复惩罚、精确匹配和召回率的平衡
- 计算: 1.
L2 Error
Collision Rate
Route Completion
路线完成度 在路线中设定一系列check-points(检查点),每通过一个 check-point,就算完成一段距离,最终完成度 = 已通过距离 / 路线总距离。
Infraction Score(IS)
安全性指标
数据集
Bench2Drive
Bench2Drive 是一个专门给端到端自动驾驶(E2E-AD)用的、闭环测试用的标准基准(benchmark),运行在 CARLA 上,用来系统地考察模型在多种驾驶能力上的表现
- 拥有顶尖专家模型Think2Drive构建的官方训练数据集 评估指标:
- Success Rate (SR) 成功率 ,是否完成每条路线的驾驶目标。必须在规定时间内、遵守交通规则、到达目标点,否则视为失败。
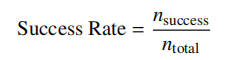
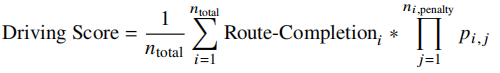
- Driving Score (DS) 驾驶评分,完成路线的比例 × 惩罚因子
- Efficiency( 效率,20 个 checkpoint,检测车辆速度是否过慢
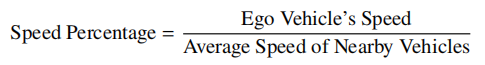
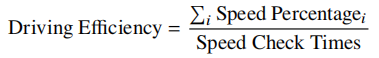
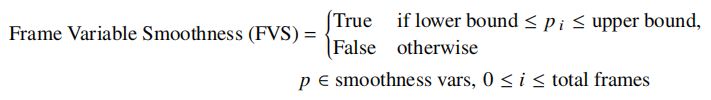
- Comfort(舒适性)用于评估车辆轨迹的 加速度、横摆角速度、jerk 等行为是否符合“人类驾驶者的舒适范围”。 帧变量平滑度FVS:
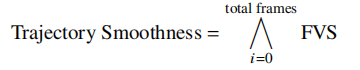
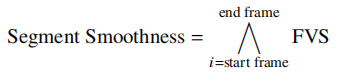
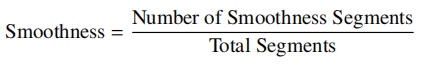
- Multi-Ability(五大能力成功率) 提供了一个大规模数据集,都是在CARLA v2环境里生成的
- Success Rate (SR) 成功率 ,是否完成每条路线的驾驶目标。必须在规定时间内、遵守交通规则、到达目标点,否则视为失败。
nuScenes
一个用于自动驾驶的多模态数据集 nuScenes 是首个提供 全传感器套件(6 cameras + 5 radars + 1 lidar)+ 360° + 属性标注 的 大规模 数据集。
- 解决痛点
- 传统数据集多为单相机,缺乏多模态传感器(如LiDAR、Radar)
- 主要贡献
- 首个完整自动驾驶多模态数据集,包括特性:
- 360°全传感器(camera+lidar+radar),雷达数据首先出现在自动驾驶数据集中。
- 1000个场景,23类+8个属性,涵盖夜间、雨天等,高精地图。
- 提供轨迹预测、检测、跟踪多个任务
- 提出新的检测与跟踪指标体系
- NDS:新的3D检测指标
- 大规模和复杂性
- 新颖的3D检测和跟踪指标 使用专家轨迹进行日志回放测试,即开环评估 通常以原始传感器信息作为输入,预测自动驾驶车辆的未来位置。评估指标方面主要采用记录轨迹的L2误差和碰撞发生率
- 首个完整自动驾驶多模态数据集,包括特性:
LiDAR:Light Detection And Ranging激光雷达 Radar:Radio Detection And Ranging毫米波雷达
- 实验指标
- 检测指标
- mAP(平均精度):mean Average Precision,看看有没有检测到物体,传统用loU,nuScenes用中心点距离
- 五大TP指标:
- ATE:Average Translation Error,平移误差,看框中心位置偏了多少,比如框偏了20cm,ATE=0.2m
- ASE:Average Scale Error,尺度误差,看框的大小是否接近真实大小,ASE=1-loU
- AOE:Average Orientation Error,朝向错误,看车的方向有多准,偏差多少度
- AVE:Average Velocity Error,速度误差,比如真正的车 10m/s,预测 12m/s → AVE = 2m/s。(nuScenes有雷达 + 多帧 LiDAR所以能测)
- AAE:Average Attribute Error,属性错误,比如行人走还是站、自行车有无人骑......
- 最终检测评分NDS(nuScenes Detection Score) NDS = mAP(50%) + 五大 TP 指标(50%)
- 跟踪指标(Tracking Metrics) 评估你是否能够持续跟踪物体,是否会跟丢,错认?
- sAMOTA —— 跟踪综合得分(主指标)。MOTA是传统指标,但是nuScenes太难很容易等于0,所以用改进版,即使你没追踪的完美也会给一个合理的评分。
- MOTP:整体跟踪准确率
- MOTP:位置误差
- TID:Track Initialization Duration,第一次成功追踪一个物体花了多久,比如看到了一个自行车但是1秒后才能稳定跟踪,TID就比较高
- LGD:Longest Gap Duration,跟踪过程中最长的丢失时间。比如行人过树之后完全跟不上,LGD就很大
- 检测指标
loU:Intersection over Union(交并比),用于目标检测评估里预测框 vs. 真实框 的重叠程度,公式:重叠面积/合并面积。对小物体不友好,如果预测框中心偏一点点可能loU就变成0了,所以nuScenes用中心点距离来判断匹配
子任务
- nuScenes Detection(3D目标检测):检测场景中的车辆、行人、自行车等,给出 3D box(大小 + 朝向 + 位置) 常用指标:
- mAP
- NDS
- TP/FP/Recall
- nuScenes Tracking(3D 多目标跟踪):在连续帧中跟踪同一个对象,预测物体的轨迹 ID。 常用指标:
- AMOTA
- AMOTP
- IDS
- nuScenes Prediction(轨迹预测):对 log 中的所有交通参与者预测未来的运动轨迹(2–6 秒) 常用指标:
- minADE
- minFDE
- Miss Rate
- Collision Rate
- nuScenes Planning(运动规划):让模型预测 自车(ego vehicle)未来 3 秒的轨迹。 常用指标:(ST-P3/UniAD两套标准)
- L2 Error
- Collision Rate
- nuScenes-lidarseg(激光点云语义分割):给每个点云点打上语义类别(道路、车、人、路缘、植被……) 常用指标:
- mloU
- nuScenes Detection(3D目标检测):检测场景中的车辆、行人、自行车等,给出 3D box(大小 + 朝向 + 位置) 常用指标:
Carla:仿真模拟平台
开发了Town05Long和Longest6等基准测试,要求自动驾驶在特定时限内安全完成多路线行驶任务。(这类任务相对简单) 最常用的基准测试:Town05-Short
Carla Leaderboard v2
新增39个高难度场景,专门用于评估自动驾驶系统在复杂交通环境中的鲁棒性。但是过于复杂,难以完美完成,不同驾驶系统中有效比较困难——得分往往都比较低
CODA-LM
Corner-case QA(极端场景问答) 是一个用于自动驾驶视觉场景问答的Corner Case(危险/罕见场景)数据集,专门评估模型在极端、异常驾驶环境下的理解能力和安全推理能力。并不是做检测、分割,而是 自然语言问答(QA)任务。 设计的具有挑战性的场景,比如行人突然闯进车道、逆行/违规车辆、突发障碍物、实现受限等。
- 问法主要包括
- General QA(整体场景理解)
- Regional QA(区域理解)
- Suggestion QA(驾驶策略 / 决策建议)
MAPLM
是一个道路语义理解的视觉问答数据集 让模型理解道路结构、道路类别、车道类型、交通属性,并用自然语言回答问题。
- 包括
- FRM(细粒度语义分类)Fine-grained Recognition Metric 即输入图像+区域,输出固定类别,本质是细粒度分类任务 eg:”红框区域是什么结构?“
- 回答:左转车道 / 右转车道 / 公交车道 / 路肩 / 单向车道
- QNS(开放式语义问答)Query-Navigated Score 即输入图像+区域,输出自然语言 eg:“描述前方道路结构。”
- FRM(细粒度语义分类)Fine-grained Recognition Metric 即输入图像+区域,输出固定类别,本质是细粒度分类任务 eg:”红框区域是什么结构?“
DriveLM
- 指标在论文p39 把问答+推理+规划整合到一个多模态VLM体系里,让大模型像老司机一样通过理解场景、回答问题再做决策。
- 数据集:(有两套数据集) DriveLM数据集是一个视觉+语言+轨迹三位一体的数据集,由两个子集构成
- DriveLM-nuScenes(真实城市数据) 新增专属标注:
- 场景理解问答 eg:“右侧有没有行人要过马路?”
- 风险/意图推理问答 eg:“有碰撞风险吗?”
- 行为选择问答 eg:“下一步应该怎么做?右转?减速?等待?”
- DriveLM-CARLA(仿真数据)
- DriveLM-nuScenes(真实城市数据) 新增专属标注:
- 实验指标(两套实验指标)
- 行为预测(Behavior Prediction)
- Accuracy(行为分类准确率),预测行为(Turn Left / Turn Right / Go Straight / Keep Lane / Stop …)是否与 Ground Truth 完全一致。
- Match(语义匹配度),模型预测的行为与真实行为之间的语义相似程度,而不是严格的分类一致,语义接近就能得高分
- 运动规划 / 轨迹预测(Motion Planning)
- L2 Error(轨迹 L2 误差),预测的未来轨迹(waypoints)与 GT 轨迹之间的 L2 距离误差 计算公式:对未来每个点计算距离误差 然后对所有点求平均
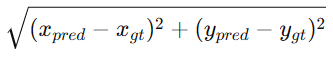
- Final Displacement Error(FDE,最终点误差),只看最后一个点的位置,衡量整体是否偏航。
- L2 Error(轨迹 L2 误差),预测的未来轨迹(waypoints)与 GT 轨迹之间的 L2 距离误差 计算公式:对未来每个点计算距离误差 然后对所有点求平均
- 行为预测(Behavior Prediction)
LingoQA
一个专为自动驾驶VQA设计的数据集。提出了一种名为Lingo-Judge的诚实度分类器,它是一个学习到的文本分类器,用于判断回答是否真实正确
- 目的:解决 BLEU/ROUGE/CIDEr 无法判断语义正确性的问题
- 输入和输出: 输入:题目(question)、人类答案(Ground Truth 论文里每题有两个)、模型回答(prediction) 输出:一个分数 P(correct)
- 公式: S = max_j F_Judge(prediction, ground_truth[j])
白车黑车顺序说反了但是中心点找对了:属于核心事实错误。 lingo-judge是用来评估语义的
OmniDrive
OmniDrive是一个基于反事实推理的自动驾驶全局视觉-语言数据集。提出了两种OmniDrive-Agent框架:
- Omni-Q:从三维感知角度设计VLMs
- Omni-L:增强VLMs三维整合能力 eg:
NuInstruct
(指标P13)
- 有 4 大类 17 个任务
- Perception 感知类任务 eg:离我最近的物体是谁?这辆车在哪条路上?
- Prediction 行为预测 eg:这辆车接下来要左转?直行?减速?
- Risk 风险判断 eg:有没有人在横穿?
- Planning with Reasoning 推理规划 eg:根据前面的感知/预测/风险 → ego 车下一步应该做什么 (例如:停车、减速、等待、直行)
- 数据生成: 由sql自动生成:
- 把原始 NuScenes 数据加工成一个巨型数据库
- 随机选三帧(前一帧、当前帧、下一帧)作为一个片段
- 运行各种 SQL 查询生成问答
- 最后人工+GPT-4 做质量过滤
- 指标
- MAE:Mean Absolute Error
- Accuracy
- MAP
- BLEU
Caption:场景描述任务 QA:问答任务 Reasoning:推理任务
BDD-X
较老?18年) 是一个基于真实行车视频的数据集,为每段驾驶行为提供两部分人工标注:行动描述(Action Description)+ 行动解释(Action Justification)
- 由6984段视频组成
- 每段视频包含多个可解释驾驶事件,每个事件都标注了两个部分:做了什么、为什么这样做 eg:The car is slowing down because the light is red.
基于 CARLA 模拟器的闭环测试(侧重驾驶任务完成度)和基于 nuScenes 数据集的开环测试(侧重轨迹预测精度)
nuScenes 的开环测试高度依赖于Ego Status (历史轨迹) 的引入,引入后 L2 误差普遍能降低到 0.3m-0.4m 区间;同时需注意 ST-P3 和 UniAD 两种不同的评价标准,避免跨标准比较造成的误判