模型微调
模型微调
1.微调方法
- 全量微调 对所有参数进行更新,更新模型中每一层的权重
- 参数高效微调PEFT
- LoRA
- QLoRA
- Adapter Tuning(适配器微调)
- Prefix Tuning / P-Tuning
- 对齐微调
- SFT监督微调
- RLHF基于人类反馈的强化学习
- DPO直接偏好优化
2.过拟合解决方法
过拟合是模型过度学习训练数据的细节和噪声,在测试集上表现差
数据增强:增加训练数据和类别,比如说对原始图片进行旋转、裁剪、调整亮度等
早停:监控验证集损失,当损失不再下降的时候停止训练
正则化:作用于权重。在损失函数里添加惩罚项:
- L1正则化:$$Loss_{L1} = Loss_0 + \lambda \sum |w|$$
:惩罚力度,设的越大惩罚约狠 :L1的特征把所有权重参数的绝对值加起来。 - L1正则化会让很多权重直接变成0,自动过滤没用的噪声特征只留下最重要的特征
L2正则化:$$Loss_{L2} = Loss_0 + \lambda \sum w^2$$防止某些权重w变得特别大,强迫模型把所有权重w都丫的很小尽量接近0但不等于0
选择: 大多时候选L2,明确的知道需要一个稀疏模型的时候(很多权重为0)选L1
Dropout:作用于神经元。防止所有神经元过于依赖某些大神(超级特征) 训练的时候:每轮随机暂时的关掉一部分神经元 测试的时候所有神经元火力全开
3.数据预处理
- 基础与几何
- 归一化:将像素值从 [0, 255] 缩放到 [0, 1] 或进行标准化(减均值、除方差)。效果:加速模型收敛,增强鲁棒性
- 数据增强:随机翻转、旋转、裁剪、缩放、色彩抖动等。效果:提升模型泛化能力,
- 语义 目标检测或者分类任务里可能会用裁剪技术将目标主体从原图里裁剪出来去除复杂背景
4.LoRA
(1) 原理
不直接微调巨大的权重更新矩阵ΔW,而是分解成两个极小的矩阵相乘
- LoRA:在原始模型旁边添加小型适配器(低秩矩阵)
- 训练时:只训练这些小的适配器参数,原始模型参数冻结
- 保存时:只保存适配器权重(文件很小)
(2) Merging
将LoRA适配器权重合并回原始模型中
- 数学原理:
其中 (LoRA低秩分解)
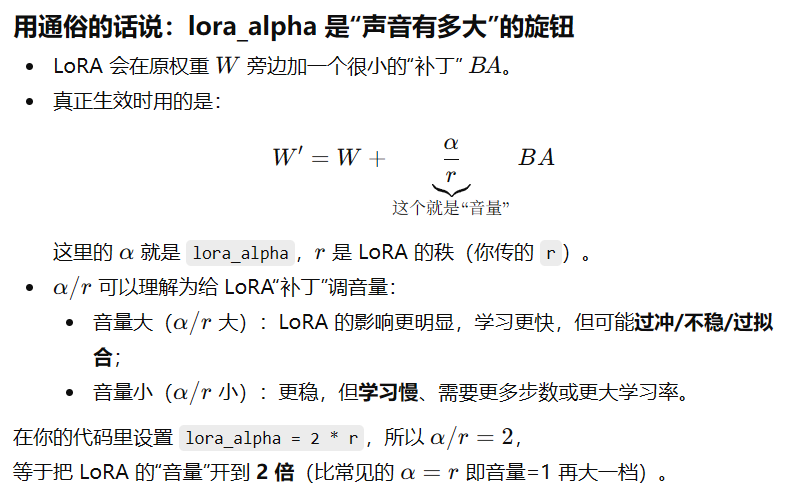
(3) lora_alpha:缩放系数
eg:
python
if model_args.use_backbone_lora:
        model.wrap_backbone_lora(r=model_args.use_backbone_lora, lora_alpha=2 * model_args.use_backbone_lora)
model.config.use_backbone_lora = model_args.use_backbone_lora- model_args.use_backbone_lora:秩
- lora_alpha=2 * model_args.use_backbone_lora):缩放系数 α=2r 的 LoRA
5. QLoRA
可以理解为LoRA的显存优化版,把基座模型 4-bit 量化并冻结,然后进行 LoRA微调。 三种降低显存的方法:
- NF4 量化:大模型权重近似正态分布,0 附近权重分布比较密集,普通的量化是均匀划分,导致 0 附近误差比较大,NF4 则是按照累积概率划分,更匹配权重划分,量化误差更小。
- 双重量化:量化需要存放缩放因子,通常每 64 个权重一个缩放因子,有一定的存储花销。双重量化把缩放因子按 256 一组进行 8-bit 量化,可以压缩存储。
- 分页优化器:优化器状态占显存大,处理长序列时容易内存溢出。分页优化器通过 NVIDIA 统一内存,显存不足时自动把优化器状态换出到 CPU 内存,需要时再调回 GPU,平滑了显存峰值。
- 量化算法
bnb(bitsandbytes) 传统,QLoRA 的底层实现库之一hqq(Half-Quadratic Quantization) 速度更快但可能不兼容eetq(Efficient Exotic Low-bit Quantization) 极致的推理速度
6. DoRA
把原先的权重分解成了方向和尺度两个维度
- 方向:用 LoRA 来更新,即
,然后做归一化 - 尺度:用一个可学习的向量单独训练,长度等于输出维度
,每个输出通道一个标量,控制该通道的“强度”。
7. LLama-Factory
dataset_info文件:
json
"数据集别名": {
    "file_name": "multimodal_demo.jsonl",
    "formatting": "sharegpt",
    "columns": {
      "messages": "messages",
      "images": "images"
    },
    "tags": {
      "role_tag": "role",
      "content_tag": "content",
      "user_tag": "user",
      "assistant_tag": "assistant"
    }
}- formatting:数据集格式
- sharegpt:多轮对话和多模态指令微调。通常包含一个
conversations列表,里面由from(角色)和value(内容)组成
- sharegpt:多轮对话和多模态指令微调。通常包含一个
json
Sharegpt
[
  {
    "id": "chat_001",
    "conversations": [
      {
        "from": "human",
        "value": "请描述这张图片中的主要物体。<image>"
      },
      {
        "from": "gpt",
        "value": "图片中是一只趴在窗边的橘猫。"
      },
      {
        "from": "human",
        "value": "需要拔掉吗?"
      },
      {
        "from": "gpt",
        "value": "不需要,建议进行充填治疗即可。"
      }
    ]
  }
]
2. alpaca (经典的单轮指令格式):单论问答
json
Alpaca
{
  "instruction": "识别图中的物体",
  "input": "",
  "output": "这是一个苹果。"
}
3. generation (纯文本格式):适用于预训练、小说续写
json
{ "text": "从前有座山,山里有座庙..." }- columns:列映射:告诉框架我的json字段对应框架内部的什么概念 messages和images在我的json里叫什么
- tags:标签映射
- role_tag:role:去找role键判断是谁说的
- content_tag:内容键
- user_tag:用户键叫什么
- assistant_tag:模型键叫什么